 Alle Bestellungen werden in Deutschland gefertigt, versandt und unterstützt
Entwickelt für KI-Anwendungen in Echtzeit
Broadberry entwickelt KI-Inferenzserver für den produktiven Betrieb trainierter KI-Modelle. Diese Systeme unterstützen Echtzeit-KI-Anwendungen wie Large Language Models (LLMs), Computer Vision, Sprachverarbeitung und Empfehlungssysteme.
Jedes System ist auf minimale Latenzzeiten, hohen Durchsatz bei Anfragen und eine konstante Performance auch unter hoher Auslastung optimiert. Je nach Anforderungen an Datenverarbeitung, Latenz und Kontrolle können die Systeme am Edge, On-Premises oder in privaten Cloud-Umgebungen eingesetzt werden.
Broadberry ist ein von NVIDIA akkreditierter Elite-Partner und verfügt über die erforderliche Expertise und Zertifizierung zur Entwicklung und Implementierung von KI-Infrastrukturlösungen, einschließlich AI PODs und AI Factories. Diese Lösungen werden gezielt auf die jeweiligen Anforderungen und spezifischen KI-Inferenz-Workloads zugeschnitten.
Kontaktieren Sie uns, um Ihre Anforderungen an KI-Inferenz zu besprechen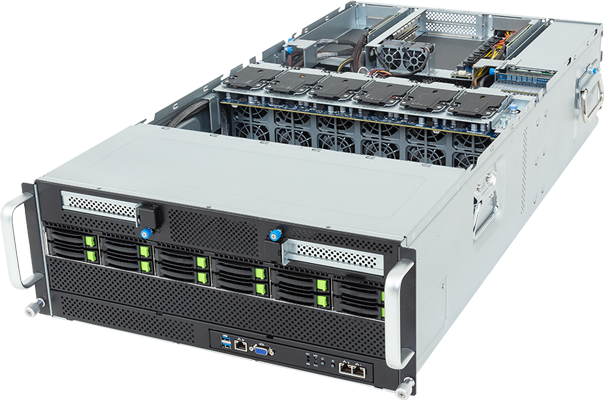

NVIDIA DGX Spark Founders Edition AI Supercomputer. Designed for a development, pre-production and concept that allows developers to test and fine tune AI Code / software stack prior to AI Production.
Single Intel Xeon 6 6900 Series processors, Supports 4x NVIDIA RTX PRO 6000 Blackwell Server Edition GPUs, dual 10Gb/s LAN ports, redundant power supply, 8x 2.5" SATA/SAS hot-swappable bays.
Dual Intel Xeon 6 Series processors, Supports NVIDIA RTX PRO 6000 Blackwell Server Edition GPUs, dual 10Gb/s LAN ports, redundant power supply, 12x 2.5" NVMe/SATA/SAS & 4x SATA/SAS hot-swappable bays.
Dual AMD EPYC 9005 / 9004 Series, Supports up to 4x NVIDIA RTX PRO 6000 Blackwell - 4x 2.5" NVMe/SATA/SAS & 4x SATA/SAS Drives.
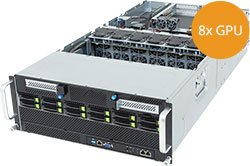
Dual AMD EPYC 9005 / 9004 Series AI Inference Server, Supports 8x NVIDIA RTX PRO 6000 Blackwell Server Edition GPUs - 12x 2.5" NVMe/SATA/SAS hot-swap drive bays.
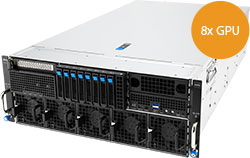
Dual AMD EPYC 9005 / 9004 Series 8x GPU Server - 4x 2.5" NVMe/SATA/SAS & 4x SATA/SAS
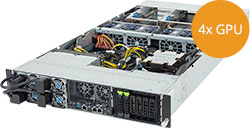
Single AMD EPYC 9005 / 9004 Series Server with 4x GPU Slots, 2x 2.5" Gen4 NVMe Hot-Swappable bays
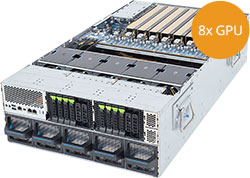
Dual Intel Xeon 6 Series processors, Supports 8x Dual slot Gen5 GPUs, dual 10Gb/s LAN ports, redundant power supply, 8x 2.5" NVMe hot-swappable bays.
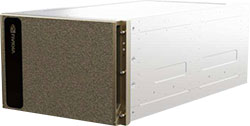
NVIDIA DGX H200 with 8x NVIDIA H200 141GB SXM5 GPU Server, Dual Intel® Xeon® Platinum Processors, 2TB DDR5 Memory, 2x 1.92TB NVMe M.2 & 8x 3.84TB NVMe SSDs.
NVIDIA DGX B200 with 8x NVIDIA Blackwell GPUs, Dual Intel® Xeon® Platinum 8570 Processors, 4TB DDR5 Memory, 2x 1.92TB NVMe M.2 & 8x 3.84TB NVMe SSDs.
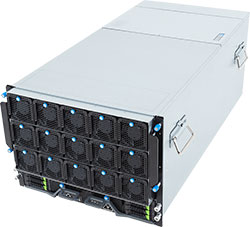
CyberServe Xeon SP2-808S G6 with 8x NVIDIA HGX B300 GPUs, Dual Intel Xeon 6 Series Processors, DDR5 Memory, 2x M.2 slots & 8x NVMe Hot swap drive bays

Dual Intel Xeon 6700/6500-Series processors, Liquid-cooled NVIDIA HGX B300, dual 10Gb/s LAN ports, redundant power supply, 8x 2.5" NVMe hot-swappable bays.

Dual AMD EPYC 9005/9004 Server Processors, Liquid-cooled NVIDIA HGX B300, 8x 800 Gb/s OSFP XDR InfiniBand or dual 400 Gb/s Ethernet ports, redundant power supply, 8x 2.5" NVMe hot-swappable bays.
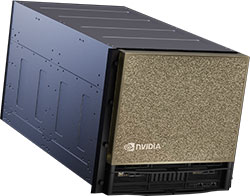
NVIDIA DGX B300 with 8x NVIDIA Blackwell Ultra SXM GPUs, Dual Intel® Xeon® 6776P Processors, 2TB DDR5 Memory, 2x 1.92TB NVMe M.2 & 8x 3.84TB E1.S NVMe.

NVIDIA DGX GB200 with 72x NVIDIA Blackwell GPUs, Dual Intel® Xeon® Platinum Processors, 4TB DDR5 Memory, 2x 1.92TB NVMe M.2 & 8x 3.84TB NVMe SSDs.
KI-Inferenz bezeichnet den Prozess, bei dem ein trainiertes Machine-Learning-Modell in einer Produktivumgebung ausgeführt wird, um auf Basis neuer Daten Vorhersagen bzw. Ergebnisse zu generieren.
Im Gegensatz zum Training, bei dem das Modell erstellt und optimiert wird, liegt der Fokus bei der Inferenz auf Geschwindigkeit, Effizienz und Skalierbarkeit. Produktive KI-Inferenzsysteme müssen große Mengen an Anfragen verarbeiten und dabei vorhersehbare und konstante Antwortzeiten gewährleisten.
Damit wird die Auslegung der IT-Infrastruktur zu einem entscheidenden Faktor. Die Performance hängt nicht allein von der verfügbaren Rechenleistung ab. Entscheidend ist vielmehr das optimale Zusammenspiel von GPUs, CPUs, Arbeitsspeicher, Storage und Netzwerk, insbesondere unter realen Workload-Bedingungen.
Die KI-Inferenzserver von Broadberry sind GPU-beschleunigte Systeme, die speziell für den produktiven Einsatz von KI-Inferenz-Workloads entwickelt wurden.
Typische Konfigurationen umfassen:
Die Systeme werden auf Basis der jeweiligen Anforderungen des KI-Inferenz-Workloads konfiguriert. Dabei werden unter anderem Modellgröße, Anzahl paralleler Anfragen (Concurrency), angestrebte Latenzzeiten und die spezifischen Anforderungen der Zielumgebung berücksichtigt.
Was ist ein KI-Inferenzserver?
Ein KI-Inferenzserver ist ein speziell für den produktiven Betrieb trainierter Machine-Learning-Modelle ausgelegtes System. Er verarbeitet neue Daten und generiert daraus in Echtzeit Ergebnisse bzw. Vorhersagen für KI-Anwendungen.
Was ist der Unterschied zwischen KI-Training und KI-Inferenz?
Beim Training wird ein KI-Modell mithilfe großer Datenmengen erstellt und optimiert. Die Inferenz nutzt dieses bereits trainierte Modell, um neue Eingaben schnell und effizient zu verarbeiten und entsprechende Ergebnisse zu liefern.
Welche Workloads benötigen KI-Inferenzserver?
Zu den typischen Einsatzbereichen gehören Inferenz von Large Language Models (LLMs), Computer Vision, Natural Language Processing (NLP), Spracherkennung und Empfehlungssysteme in produktiven KI-Umgebungen.
Die KI-Inferenzsysteme von Broadberry werden auf Basis der jeweiligen Anforderungen an den Inferenz-Workload optimal auf Rechenleistung, Storage, Energieversorgung und Bauform abgestimmt. Jede Komponente wird gezielt ausgewählt, um Anforderungen an Durchsatz, Latenz und die jeweilige Einsatzumgebung zu erfüllen.
Für die parallele Ausführung von KI-Modellen ausgelegt und ermöglichen hohe Durchsatzraten bei KI-Inferenz-Workloads mit einer Vielzahl gleichzeitig zu verarbeitender Anfragen.
Maximieren die Rechenleistung pro Höheneinheit und eignen sich für Rechenzentren, in denen Platzbedarf und Energieeffizienz entscheidende Faktoren sind.
Geeignet für leichtere bzw. energieeffiziente KI-Inferenz-Workloads, die keine vollständige GPU-Beschleunigung erfordern.
Entwickelt für KI-Inferenzumgebungen mit hohem Anfragevolumen und geringem Energieverbrauch, einschließlich Edge- und verteilten Deployment-Szenarien.
Reduziert die Ladezeiten von KI-Modellen und ermöglicht einen schnellen Zugriff auf große Datenmengen.
Ermöglichen die parallele Verarbeitung zahlreicher Inferenzanfragen, ohne dass I/O-Engpässe die Systemleistung beeinträchtigen.
Ermöglicht die effiziente Verwaltung und den schnellen Abruf mehrerer KI-Modelle in produktiven Umgebungen.
Unterstützt leistungsdichte GPU-Konfigurationen und gewährleistet gleichzeitig einen stabilen und zuverlässigen Betrieb.
Ermöglicht eine höhere Rechendichte und dauerhaft hohe Performance in Umgebungen mit besonderen thermischen Anforderungen.
Unterstützt eine hohe Rechendichte und eine dauerhaft konstante Leistung auch unter thermisch anspruchsvollen Betriebsbedingungen.
Entwickelt für Einsatzumgebungen mit begrenztem Platzangebot, eingeschränkter Energieversorgung oder besonderen Umgebungsbedingungen.
Unterstützen unterschiedliche Einsatzgrößen – von einzelnen Server-Nodes bis hin zu skalierbaren Systemumgebungen.
Ermöglichen die horizontale Skalierung für besonders anspruchsvolle KI-Inferenz-Workloads.
Die Systeme sind für eine Vielzahl von KI-Inferenz-Workloads ausgelegt, darunter:
Jeder Workload stellt unterschiedliche Anforderungen an Rechenleistung, Arbeitsspeicher und Datenübertragung. Die Systemkonfigurationen werden entsprechend auf den jeweiligen Anwendungsfall abgestimmt, um Bottlenecks zu vermeiden und eine konstante Performance sicherzustellen.
KI-Inferenzsysteme unterliegen anderen Anforderungen als Umgebungen für die Entwicklung und das Training von KI-Modellen.
Zu den wichtigsten Anforderungen gehören:
Broadberry entwickelt seine Systeme gezielt für diese Anforderungen und gewährleistet damit eine zuverlässige und konstante Performance – auch bei steigender Workload-Last und zunehmender Skalierung.
Diese KI-Inferenzsysteme kommen typischerweise zum Einsatz bei:
Sie eignen sich insbesondere für Einsatzumgebungen, in denen geringe Latenz, Kontrolle über Daten und eine vorhersehbare Systemleistung entscheidend sind.
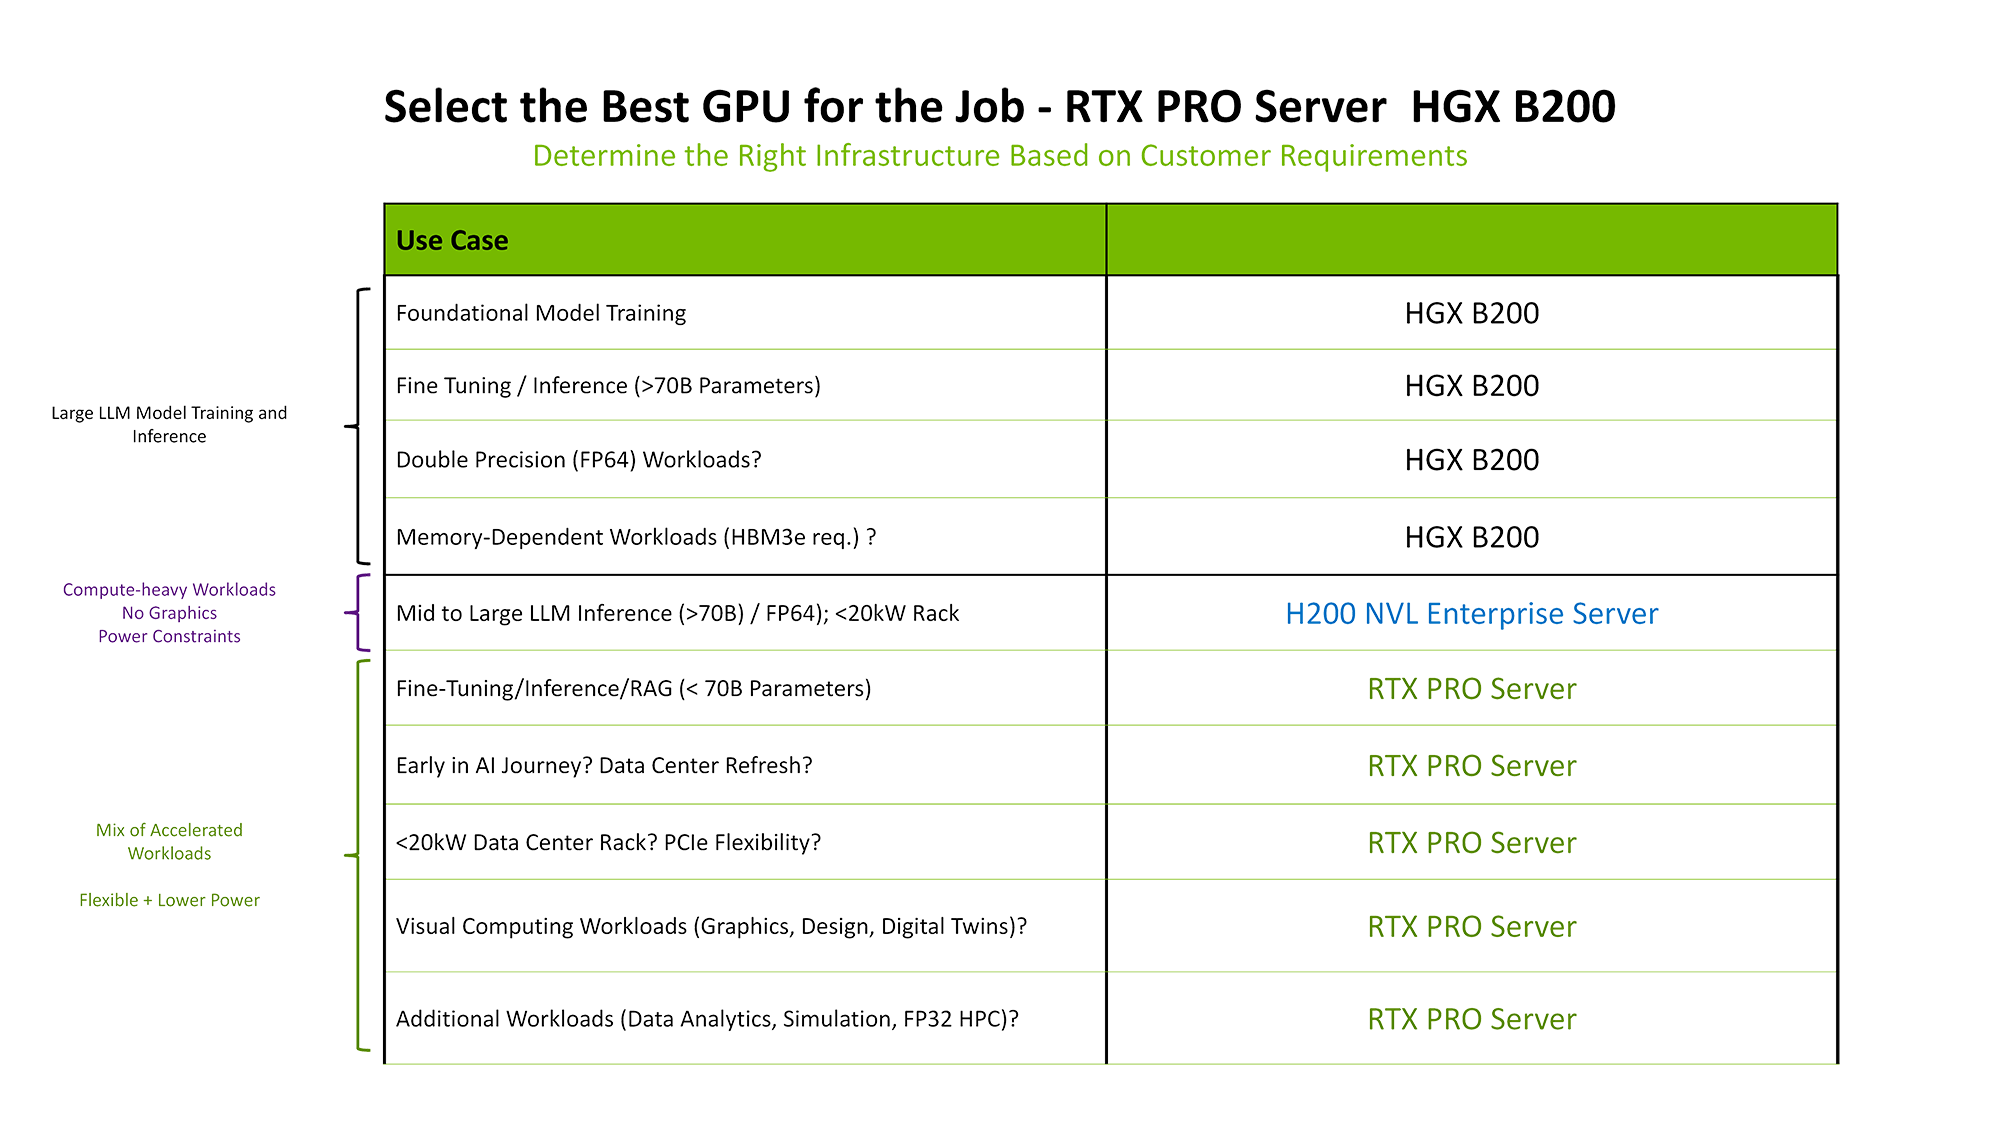
Warum werden GPUs für die KI-Inferenz eingesetzt?
GPUs beschleunigen die parallele Verarbeitung und ermöglichen es KI-Inferenzservern, mehrere Anfragen gleichzeitig zu verarbeiten. Dadurch werden der Datendurchsatz erhöht und die Antwortzeiten reduziert – insbesondere bei Echtzeitanwendungen.
Was bedeutet Low-Latency-Inferenz?
Low Latency bezeichnet die Zeitspanne zwischen dem Eingang einer Anfrage und der Bereitstellung des Ergebnisses. KI-Inferenzsysteme sind darauf ausgelegt, diese Verzögerung so gering wie möglich zu halten – insbesondere bei Anwendungen, die eine Verarbeitung in Echtzeit erfordern.
Wann sollte KI-Inferenz On-Premises statt in der Cloud betrieben werden?
Ein On-Premises-Betrieb ist insbesondere dann sinnvoll, wenn geringe Latenzzeiten, Datenschutz und Datenhoheit oder eine vorhersehbare Performance erforderlich sind. Auch bei dauerhaft hohen Workloads kann sich eine dedizierte Infrastruktur wirtschaftlich und technisch lohnen.
Wie dimensioniert man einen KI-Inferenzserver?
Die Dimensionierung hängt von verschiedenen Faktoren ab, darunter Modellgröße, Anzahl gleichzeitiger Benutzer bzw. Anfragen, angestrebte Latenzzeiten und Datenvolumen. Auch GPU-Typ, Speicherkapazität und Storage-Geschwindigkeit spielen eine entscheidende Rolle.
Welche Rolle spielt der Storage für die Inferenz-Performance?
Schneller Storage, beispielsweise NVMe-Storage, reduziert die Ladezeiten von KI-Modellen und ermöglicht einen hohen Datendurchsatz. Dies ist entscheidend, um auch unter hoher Auslastung eine konstante und zuverlässige Inferenz-Performance sicherzustellen.
Können KI-Inferenzsysteme horizontal skaliert werden?
Ja. KI-Inferenz-Workloads können über mehrere Server bzw. Nodes verteilt werden. Durch diese horizontale Skalierung lassen sich steigende Anfragevolumina bewältigen, indem die Workloads auf zusätzliche Systeme verteilt werden.
Welche Branchen setzen KI-Inferenzserver ein?
KI-Inferenzserver kommen unter anderem in den Bereichen Finanzdienstleistungen, Gesundheitswesen, Einzelhandel, Medien, Industrie und Forschung zum Einsatz – überall dort, wo Echtzeit-Datenverarbeitung und automatisierte Entscheidungsprozesse erforderlich sind.
Die KI-Inferenzserver von Broadberry unterstützen alle gängigen KI-Frameworks und Inference-Runtimes und ermöglichen damit den Einsatz in Edge-, On-Premises- und Cloud-Umgebungen.
Dadurch können KI-Modelle von der Entwicklungsumgebung in den produktiven Betrieb überführt werden, ohne bestehende KI-Workflows grundlegend anpassen zu müssen.
Broadberry bietet End-to-End-Support für die Implementierung, Bereitstellung und den Betrieb von KI-Infrastrukturen.
Die Systeme werden für den langfristigen, produktiven Einsatz von KI-Infrastrukturen entwickelt, bereitgestellt und unterstützt.
KI-Inferenzsysteme sind darauf ausgelegt, auch bei skalierenden Workloads effizient zu arbeiten.
Dies ist insbesondere bei hohen Anfragevolumina und dauerhaft betriebenen (Always-on) KI-Inferenz-Workloads von Bedeutung.
Broadberry verfügt über mehr als 30 Jahre Erfahrung in der Bereitstellung leistungsfähiger IT-Infrastrukturen für internationale Unternehmen, Forschungseinrichtungen und staatliche Organisationen.
Die KI-Inferenzserver werden gezielt auf die jeweiligen Anforderungen des Workloads abgestimmt. Dadurch entsteht ein optimales Verhältnis aus Performance, Energieeffizienz und Gesamtbetriebskosten (TCO) – für einen zuverlässigen und wirtschaftlichen langfristigen KI-Betrieb.
 Unser präzises Testing
Alle Broadberry Server- und Storage-Lösungen durchlaufen vor dem Versand aus unserem Lagerhaus einen 48-stündigen Testlauf. In Kombination mit diesem Prüfverfahren sowie den hochqualitativen, branchenführenden Komponenten stellen wir sicher, dass all unsere Server- und Storage-Lösungen den strengsten Qualitätsrichtlinien entsprechen, die an uns gestellt werden.
 Unübertroffene Flexibilität
Unser Hauptziel ist es, hochwertige Server- und Speicherlösungen zu einem hervorragenden Preis-Leistungs-Verhältnis anzubieten. Wir wissen, dass jedes Unternehmen unterschiedliche Anforderungen hat, und sind daher in der Lage, unübertroffene Flexibilität bei der Gestaltung maßgeschneiderter Server- und Speicherlösungen anzubieten, um die Bedürfnisse unserer Kunden zu erfüllen.
Wir haben uns als einer der größten Storageanbieter im Vereinigten Königreich etabliert und beliefern seit 1989 die weltweit führenden Marken mit unseren Server- und Storagelösungen. Zu unseren Kunden zählen:
Broadberry Data Systems Allows Buyers to Test Drive New NVIDIA GPU-accelerated Servers
Broadberry Data Systems Allows Buyers to Test Drive New NVIDIA GPU-accelerated Servers
London, UK– Jan 26, 2021 – Broadberry Data Systems, one of the U.K.’s leading providers of customised s
impressum / returns / mein konto / Kontaktieren Sie uns / new accounts
CyberServe EPYC EP1-102A
A powerful AMD EPYC rack server for small spaces...
| August 26, 2026
CyberServe Ryzen RY1-104A
A core-heavy Ryzen rack server at an entry-level price ...
| April 01, 2024
CyberServe Xeon SP1-102G NVMe G5
A small, powerful, and affordable rack server.
Broadberry gets edgy with a great value rack server...
| December 01, 2023
Intel M50CYP2UR208 Coyote Pass Server - 8 Drive Bays. SAS/SATA/NVME
A mighty server package for the price with a big helping of blisteringly fast Intel Optane 200 PMEMs...
| August 02, 2021
 Rufen Sie bitte unseren Verkauf an


