 Alle Bestellungen werden in Deutschland gefertigt, versandt und unterstützt
Entwickelt für Modellentwicklung und skalierbares KI-Training
Broadberry entwickelt leistungsstarke KI-Trainingsserver und KI-Trainingsinfrastrukturen für die Entwicklung und Optimierung von Machine-Learning-Modellen. Die Systeme unterstützen anspruchsvolle Workloads wie das Training großer Sprachmodelle (LLMs), Deep Learning und verteiltes KI-Training.
Von Einstiegssystemen für die frühe Entwicklungsphase wie NVIDIA DGX Spark bis hin zu vollständig skalierten NVIDIA SuperPODs und kompletten KI-Fabriken unterstützt Broadberry KI-Training in jeder Phase der Implementierung.
KI-Training erfordert eine hohe Rechendichte, schnelle GPU-zu-GPU-Kommunikation und einen effizienten Datentransfer. Genau dafür sind die KI-Trainingsserver von Broadberry konzipiert – leistungsstark, skalierbar und für anspruchsvolle Trainingsumgebungen optimiert.
Als NVIDIA Elite Partner verfügt Broadberry über die erforderliche Expertise und Zertifizierung, um KI-Trainingsinfrastrukturen wie KI-PODs und KI-Fabriken zu konzipieren und aufzubauen, die gezielt auf individuelle KI-Trainingsworkloads abgestimmt sind.
Kontaktieren Sie uns, um Ihre Anforderungen an KI-Training zu besprechen.

NVIDIA DGX Spark Founders Edition AI Supercomputer. Designed for a development, pre-production and concept that allows developers to test and fine tune AI Code / software stack prior to AI Production.

Dual Intel Xeon 6 Series processors, dual 10Gb/s LAN ports, redundant power supply, 8x 2.5" NVMe/SATA/SAS hot-swappable bays.
Single AMD EPYC 9005 / 9004 Series, Supports up to 4x FHFL PCIe Gen5 x16 slots - 4x 2.5" NVMe/SAS/SATA & 4x 2.5" SAS/SATA Drives.
Single AMD EPYC 9005 / 9004 Series, Supports up to 8x FHFL PCIe Gen5 x16 slots - 4x 2.5" NVMe/SAS/SATA & 4x 2.5" SAS/SATA Drives.
Single AMD EPYC 9005 / 9004 Series, Supports up to 8x FHFL PCIe Gen5 x16 slots - 4x 2.5" NVMe/SAS/SATA & 4x 2.5" SAS/SATA Drives.
Dual AMD EPYC 9005 / 9004 Series, Supports up to 4x dual-slot Gen5 GPUs - 4x 2.5" NVMe/SATA & 4x SATA Drives.
Short Depth Dual AMD EPYC 9005 / 9004 Series Server with 4x GPU Slots, 6x 2.5" Gen4 NVMe Hot-Swappable bays
Short Depth Dual AMD EPYC 9005 / 9004 Series Server with 4x GPU Slots, 6x 2.5" Gen4 NVMe Hot-Swappable bays
Dual AMD EPYC 9005 / 9004 Series, Supports up to 8x FHFL PCIe Gen5 x16 slots - 4x 2.5" NVMe/SATA/SAS & 4x SATA/SAS Drives.
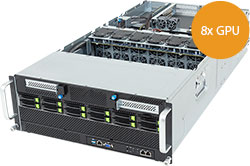
Dual Intel Xeon 6 Series processors, Supports 8x Dual slot Gen5 GPUs, dual 10Gb/s LAN ports, redundant power supply, 12x 2.5" NVMe/SATA/SAS & 4x SATA/SAS hot-swappable bays.
Dual AMD EPYC 9005 / 9004 Series, Supports up to 8x FHFL PCIe Gen5 x16 slots - 4x 2.5" NVMe/SATA/SAS & 4x SATA/SAS Drives.

Dual AMD EPYC 9005 Series Server - Supports 8x Dual Slot GPU Accelerator Cards, 4x 2.5" NVMe & 2x SATA Hot Swap Drive Bays
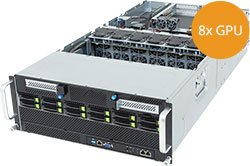
Dual AMD EPYC 9005 / 9004 Series 8x GPU Server - 12x 2.5" NVMe/SATA/SAS
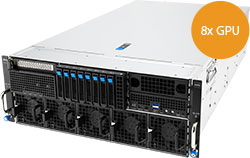
Dual AMD EPYC 9005 / 9004 Series 8x GPU Server - 4x 2.5" NVMe/SATA/SAS & 4x SATA/SAS
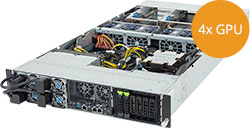
Single AMD EPYC 9005 / 9004 Series Server with 4x GPU Slots, 2x 2.5" Gen4 NVMe Hot-Swappable bays
Dual AMD EPYC 9005 / 9004 Series 8x GPU Server - 12x 2.5" NVMe/SATA/SAS
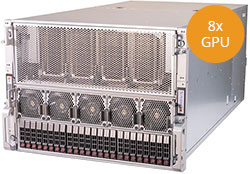
Supports 8x HGX H200 GPUs, dual 10Gb/s BASE-T LAN ports, redundant power supply, 16 x 2.5" NVMe, 8x SATA hot-swappable bays. Built for AI Training and Inferencing.
NVIDIA DGX H200 with 8x NVIDIA H200 141GB SXM5 GPU Server, Dual Intel® Xeon® Platinum Processors, 2TB DDR5 Memory, 2x 1.92TB NVMe M.2 & 8x 3.84TB NVMe SSDs.
NVIDIA DGX B200 with 8x NVIDIA Blackwell GPUs, Dual Intel® Xeon® Platinum 8570 Processors, 4TB DDR5 Memory, 2x 1.92TB NVMe M.2 & 8x 3.84TB NVMe SSDs.
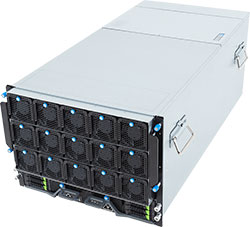
CyberServe Xeon SP2-808S G6, NVIDIA HGX™ B300 with 8 x SXM GPUs, Dual Intel Xeon 6 Series Processors, DDR5 Memory, 2x M.2 slots & 8x NVMe Hot swap drive bays
NVIDIA DGX B300 with 8x NVIDIA Blackwell Ultra SXM GPUs, Dual Intel® Xeon® 6776P Processors, 2TB DDR5 Memory, 2x 1.92TB NVMe M.2 & 8x 3.84TB E1.S NVMe.

NVIDIA DGX GB200 with 72x NVIDIA Blackwell GPUs, Dual Intel® Xeon® Platinum Processors, 4TB DDR5 Memory, 2x 1.92TB NVMe M.2 & 8x 3.84TB NVMe SSDs.
Was ist ein KI-Trainingsserver?
Ein KI-Trainingsserver ist ein speziell entwickeltes System für die Erstellung und Optimierung von Machine-Learning-Modellen mithilfe großer Datensätze und leistungsstarker Computing-Ressourcen.
Welche Hardware wird für KI-Training benötigt?
KI-Training erfordert typischerweise GPUs, Hochgeschwindigkeits-Interconnects, große Speicherkapazitäten sowie performanten Storage, um Parallelverarbeitung und hohe Datendurchsätze zu ermöglichen.
Was ist der Unterschied zwischen KI-Training und KI-Inferenz?
Beim KI-Training wird ein Modell erstellt und optimiert. Bei der KI-Inferenz wird das bereits trainierte Modell verwendet, um auf Basis neuer Daten Vorhersagen oder Ergebnisse zu generieren.
KI-Training bezeichnet den Prozess, bei dem ein Machine-Learning-Modell mithilfe großer Datenmengen aufgebaut und seine Parameter schrittweise angepasst und optimiert werden.
Im Gegensatz zur Inferenz, bei der ein bereits trainiertes Modell ausgeführt wird, ist das Training äußerst rechenintensiv und erfordert eine koordinierte Verarbeitung über mehrere GPUs und Nodes hinweg. Die Performance hängt entscheidend davon ab, wie effizient Daten verarbeitet werden und wie schnell ein System die einzelnen Trainingszyklen durchlaufen kann.
Die Leistungsfähigkeit beim KI-Training wird typischerweise anhand folgender Faktoren bewertet:
KI-Training und KI-Inferenz übernehmen unterschiedliche Aufgaben innerhalb des Machine-Learning-Lebenszyklus und stellen entsprechend unterschiedliche Anforderungen an die Infrastruktur.
| Bereich | KI-Training | KI-Inferenz |
|---|---|---|
| Hauptaufgabe | Modelle mithilfe großer Datensätze erstellen und optimieren | Trainierte Modelle für Vorhersagen und Ergebnisse einsetzen |
| Kernprozess | Iterative Berechnungen und Parameteroptimierung | Echtzeit- oder Batch-Verarbeitung neuer Daten |
| Rechenanforderungen | Sehr hoch, häufig verteilt über mehrere GPUs | Mittel bis hoch, abhängig vom jeweiligen Workload |
| Wichtige Anforderungen | Parallele Verarbeitung über mehrere GPUs, High-Bandwidth-Interconnects, effizientes Laden und Vorverarbeiten von Daten |
Niedrige Latenz, hoher Request-Durchsatz , konstante Antwortzeiten |
| Typische Umgebung | Trainingscluster und Multi-Node-Systeme | Edge-, On-Premises- oder Cloud-Umgebungen |
| Performance-Fokus | Time to Convergence und Trainingseffizienz | Antwortzeit und Durchsatz |
Broadberry KI-Trainingsserver wurden entwickelt, um die Modellentwicklung zu beschleunigen, Trainingszeiten zu reduzieren und verteiltes KI-Training effizient zu skalieren.
Typische Konfigurationen umfassen:
Die Systeme werden entsprechend der Modellgröße, dem Umfang der Datensätze und der jeweiligen Trainingsarchitektur konfiguriert – einschließlich Multi-GPU- und Multi-Node-Trainingsumgebungen.
Die GPU-dichten Plattformen von Broadberry sind für führende KI-Frameworks wie PyTorch, TensorFlow und JAX optimiert und unterstützen aktuelle Beschleunigertechnologien von NVIDIA und AMD.
Die Performance beim KI-Training wird häufig nicht allein durch die verfügbare Rechenleistung begrenzt.
Zu den häufigsten Bottlenecks gehören:
Die Optimierung dieser Bereiche erhöht die Trainingseffizienz, verkürzt die Time to Convergence und maximiert die GPU-Auslastung.
Eine optimal abgestimmte Infrastruktur sorgt dafür, dass wertvolle GPU-Ressourcen kontinuierlich ausgelastet bleiben, anstatt aufgrund langsamer Datenbereitstellung oder Kommunikationsengpässen auf Daten warten zu müssen.
Die KI-Trainingsserver von Broadberry unterstützen ein breites Spektrum anspruchsvoller KI-Trainingsworkloads, darunter:
Jeder dieser Workloads stellt unterschiedliche Anforderungen an Rechenleistung, Speicher und Datentransfer. Die Systemkonfigurationen werden deshalb gezielt auf den jeweiligen Anwendungsfall abgestimmt, um ein effizientes Training auch in großem Maßstab sicherzustellen.
KI-Trainingsserver werden typischerweise eingesetzt von:
Diese Systeme kommen überall dort zum Einsatz, wo hohe Rechenleistung, Kontrolle über die eigenen Daten und maximale Trainingseffizienz entscheidend sind.
Broadberry unterstützt Unternehmen in jeder Entwicklungsphase – von den ersten Schritten bei der Modellentwicklung bis hin zum Aufbau umfangreicher KI-Trainingsinfrastrukturen.
| Phase | Was Broadberry ermöglicht | |||
|---|---|---|---|---|
| General Purpose | ||||
| Datenaufbereitung | Storage mit hoher Kapazität, schnelle Datenaufnahme und skalierbare Rechenleistung für die Verarbeitung großer Datensätze | |||
| Modelltraining | GPU-dichte KI-Trainingsserver, HPC-Cluster und High-Bandwidth-Interconnects für verteiltes Training | |||
| Hyperparameter-Tuning | Verteilte Rechenleistung, automatisierte Skalierung und parallele Experimente über mehrere Trainingsläufe hinweg | |||
| Modellbereitstellung | Edge-Systeme, KI-Inferenzserver und produktionsreife Infrastruktur | |||
| Monitoring und Optimierung | Enterprise-Class-Zuverlässigkeit, Remote Management und langfristiger Support für produktive KI-Umgebungen | |||
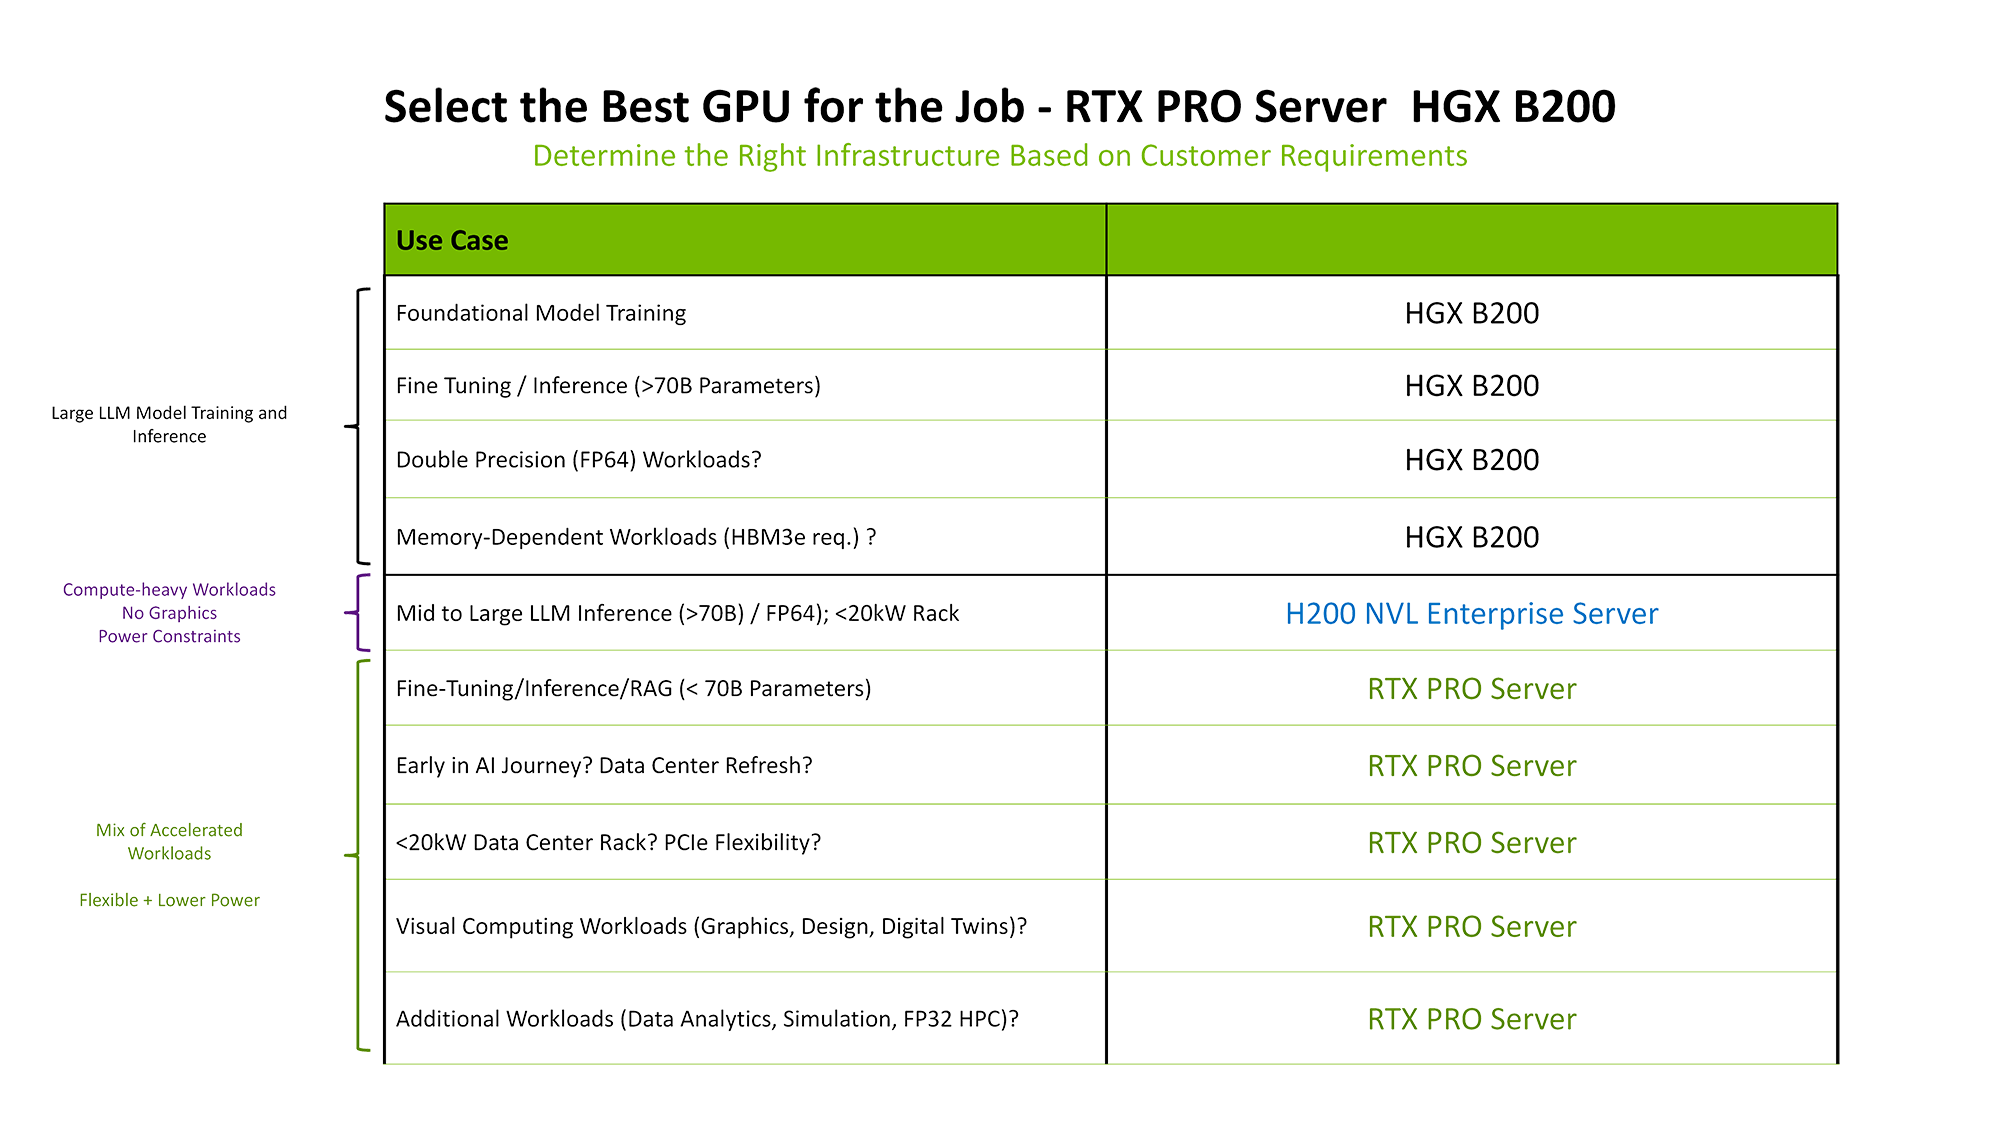
Was ist ein KI-Trainingsserver?
Ein KI-Trainingsserver ist ein System, das speziell für die Entwicklung und Optimierung von Machine-Learning-Modellen mithilfe großer Datensätze, GPUs und leistungsstarker Computing-Infrastruktur konzipiert wurde.
Was ist der Unterschied zwischen KI-Training und KI-Inferenz?
Beim KI-Training wird ein Modell mithilfe von Daten und iterativen Berechnungen aufgebaut und optimiert. Bei der KI-Inferenz wird dieses trainierte Modell anschließend eingesetzt, um auf Grundlage neuer Daten Vorhersagen oder Ergebnisse zu generieren.
Welche Hardware wird für KI-Training benötigt?
Typischerweise werden GPUs, High-Speed-Interconnects, große Speicherkapazitäten und schneller Storage benötigt. Diese Komponenten ermöglichen Parallelverarbeitung, Distributed Training und einen hohen Datendurchsatz.
Wie viele GPUs benötige ich für KI-Training?
Die erforderliche Anzahl an GPUs hängt von der Modellgröße, dem Umfang der Datensätze und den gewünschten Trainingszeiten ab. Größere Modelle und kürzere Trainingszeiten erfordern in der Regel mehr GPUs sowie verteiltes Training über mehrere Nodes.
Was ist Distributed Training?
Beim Distributed Training wird ein Modell gleichzeitig über mehrere GPUs oder Server hinweg trainiert. Dadurch können Trainingszeiten reduziert und größere Modelle effizient trainiert werden.
Welche Rolle spielen GPU-Interconnects beim Training?
High-Speed-Interconnects wie NVLink und InfiniBand ermöglichen eine effiziente Kommunikation zwischen den GPUs. Dadurch werden Bottlenecks reduziert und die Trainingsperformance in Multi-GPU-Systemen verbessert.
Wie lange dauert KI-Training?
Die Trainingsdauer hängt von der Komplexität des Modells, der Größe des Datensatzes und der Systemkonfiguration ab. Je nach Workload kann ein Training wenige Stunden bis hin zu mehreren Wochen dauern.
Was bedeutet Time to Convergence?
Time to Convergence beschreibt die Zeit, die ein Modell benötigt, um während des Trainings ein akzeptables Genauigkeitsniveau zu erreichen. Sie ist eine wichtige Kennzahl zur Bewertung der Trainingsperformance.
Wie wichtig ist die Storage-Performance für KI-Training?
Eine hohe Storage-Performance ist entscheidend. Schneller Storage wie NVMe sorgt dafür, dass Datensätze mit hoher Geschwindigkeit bereitgestellt werden können und GPUs nicht aufgrund langsamer Datenzufuhr ungenutzt bleiben.
Wie viel Speicher wird für KI-Training benötigt?
Der Speicherbedarf hängt von der Modellgröße und der verwendeten Batch Size ab. Große Modelle benötigen erhebliche Mengen an GPU-Speicher sowie System-RAM, um effizient ausgeführt und trainiert werden zu können.
Welche Bottlenecks beeinflussen die Performance beim KI-Training?
Zu den häufigsten Engpässen gehören langsames Laden von Daten, begrenzter GPU-Speicher und ineffiziente Kommunikation zwischen GPUs.
Sollte KI-Training On-Premises oder in der Cloud erfolgen?
On-Premises-Training bietet mehr Kontrolle über Performance, Kosten und Datensicherheit. Cloud-Training bietet dagegen hohe Flexibilität und Skalierbarkeit. Welche Variante besser geeignet ist, hängt von Workload-Größe, Budget und den jeweiligen betrieblichen Anforderungen ab.
Wann lohnt sich der Aufbau eines dedizierten Trainingsclusters?
Ein dedizierter Trainingscluster ist insbesondere dann sinnvoll, wenn KI-Workloads groß, kontinuierlich oder langfristig angelegt sind und planbare Performance sowie Kostenkontrolle erforderlich sind.
Können KI-Trainingssysteme später erweitert werden?
Ja. KI-Trainingsinfrastrukturen lassen sich durch zusätzliche GPUs oder weitere Nodes skalieren und können damit gemeinsam mit steigenden Modell- und Datenanforderungen wachsen.
Wie wird ein KI-Trainingsserver richtig dimensioniert?
Die Dimensionierung hängt von der Modellarchitektur, der Größe des Datensatzes, dem verwendeten Trainingsframework und den angestrebten Performance-Zielen ab.
GPU-Anzahl, Speicher, Storage und Netzwerk müssen optimal aufeinander abgestimmt werden.
Broadberry arbeitet gemeinsam mit Kunden daran, diese Faktoren anhand realer Workloads zu bewerten und eine passende KI-Trainingsarchitektur zu entwickeln.
Welche Frameworks werden von KI-Trainingsservern unterstützt?
Broadberry KI-Trainingsserver unterstützen etablierte Frameworks wie PyTorch, TensorFlow und JAX und ermöglichen damit die Entwicklung und das Training von Modellen mit gängigen Standardwerkzeugen.
Welche Branchen setzen KI-Trainingsserver ein?
KI-Trainingsserver kommen unter anderem im Gesundheitswesen, bei Finanzdienstleistern, in der Fertigung, Forschung und Medienbranche sowie überall dort zum Einsatz, wo Modelle in großem Maßstab entwickelt und trainiert werden.
Broadberry Data Systems genießt das Vertrauen von Unternehmen, Behörden, Forschungseinrichtungen und Cloud-Providern weltweit.
Unsere KI-Trainingsplattformen sind für langfristige produktive KI-Umgebungen konzipiert, in denen Zuverlässigkeit, professioneller Support und eine vorausschauende Lifecycle-Planung entscheidend sind.
KI-Trainingsserver kommen in zahlreichen Branchen zum Einsatz, die Modelle in großem Maßstab entwickeln und datenintensive KI-Workloads verarbeiten, darunter:
 Unser präzises Testing
Alle Broadberry Server- und Storage-Lösungen durchlaufen vor dem Versand aus unserem Lagerhaus einen 48-stündigen Testlauf. In Kombination mit diesem Prüfverfahren sowie den hochqualitativen, branchenführenden Komponenten stellen wir sicher, dass all unsere Server- und Storage-Lösungen den strengsten Qualitätsrichtlinien entsprechen, die an uns gestellt werden.
 Unübertroffene Flexibilität
Unser Hauptziel ist es, hochwertige Server- und Speicherlösungen zu einem hervorragenden Preis-Leistungs-Verhältnis anzubieten. Wir wissen, dass jedes Unternehmen unterschiedliche Anforderungen hat, und sind daher in der Lage, unübertroffene Flexibilität bei der Gestaltung maßgeschneiderter Server- und Speicherlösungen anzubieten, um die Bedürfnisse unserer Kunden zu erfüllen.
Wir haben uns als einer der größten Storageanbieter im Vereinigten Königreich etabliert und beliefern seit 1989 die weltweit führenden Marken mit unseren Server- und Storagelösungen. Zu unseren Kunden zählen:
Broadberry Data Systems Allows Buyers to Test Drive New NVIDIA GPU-accelerated Servers
Broadberry Data Systems Allows Buyers to Test Drive New NVIDIA GPU-accelerated Servers
London, UK– Jan 26, 2021 – Broadberry Data Systems, one of the U.K.’s leading providers of customised s
impressum / returns / mein konto / Kontaktieren Sie uns / new accounts
CyberServe EPYC EP1-102A
A powerful AMD EPYC rack server for small spaces...
| August 26, 2026
CyberServe Ryzen RY1-104A
A core-heavy Ryzen rack server at an entry-level price ...
| April 01, 2024
CyberServe Xeon SP1-102G NVMe G5
A small, powerful, and affordable rack server.
Broadberry gets edgy with a great value rack server...
| December 01, 2023
Intel M50CYP2UR208 Coyote Pass Server - 8 Drive Bays. SAS/SATA/NVME
A mighty server package for the price with a big helping of blisteringly fast Intel Optane 200 PMEMs...
| August 02, 2021
 Rufen Sie bitte unseren Verkauf an


